两小时。设置一个都不用动。订阅里的字,开始往外涌。
10月5日,OpenAI 核心产品负责人 Thibault Sottiaux,圈子里叫他 Tibo,X 账号 @thsottiaux,发了一条短帖。开头就是 Day 1。炸了!刷屏了!28天那份「要么改进、要么重置」的约定,第一天交上来的不是新按钮,是速度!
他写的是:通过订阅,GPT-6 Astra 和 GPT-6.1 Sol 的默认速度被优化到大约快 50%。覆盖 OpenAI 自家全部产品,也覆盖使用 Sign in with ChatGPT 的合作方。点名的有 OpenCode、Pi、Amp、Devin。你不用做任何改动。他说,接下来两小时内就该感觉到。
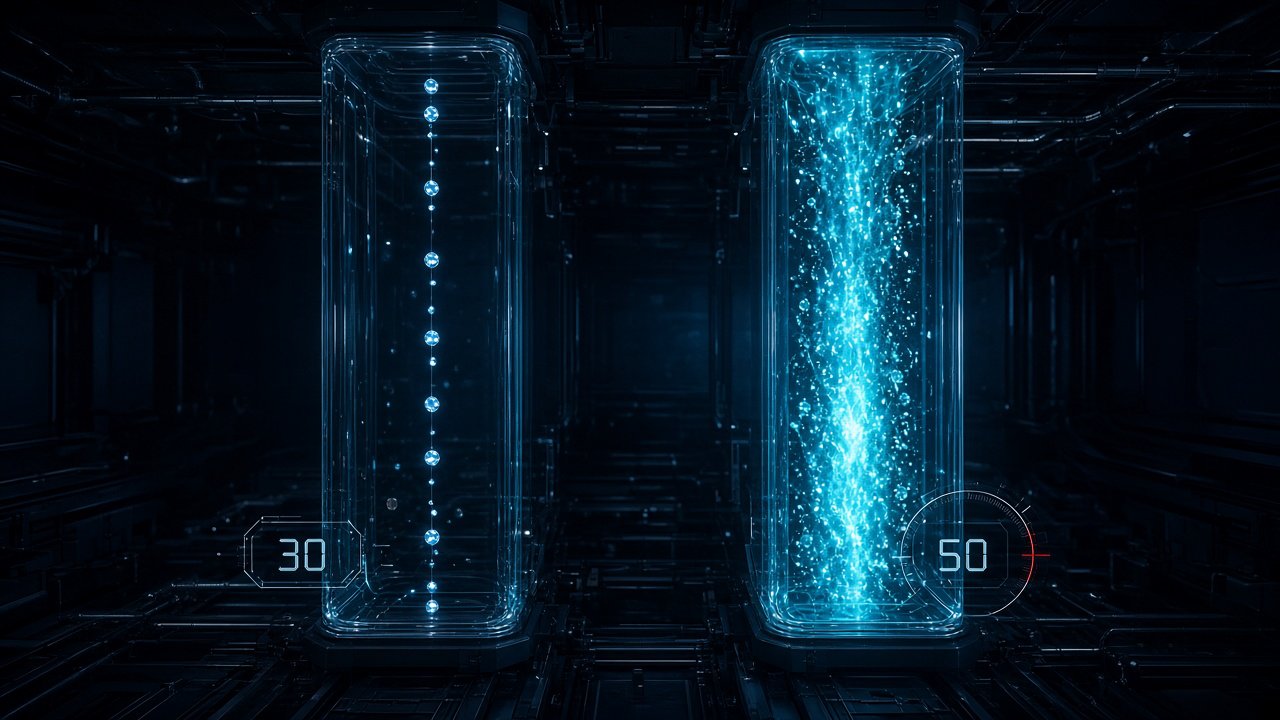
随后数字被说得更具体。两款模型现在大约每秒生成 50 个 token,之前大约是 30 个。有报道称,这条帖子浏览量超过 160 万。
2026年10月6日,哈基米云报道。
官方说一半,两个数算出来是三分之二
官方口径是「大约快 50%」。把 30 和 50 按字面相除,增幅大约是 67%。两个说法对不上!Tibo 把速率都说成大约,没有解释差距从哪来,也没有说这是怎么测的:是不是每个产品、每个套餐、每种任务都一样快。
一种读法是,50% 指的是端到端体感,里面含着第一个 token 要等多久;单看生成阶段,才是三分之二。这只是读法。帖子本身没这么拆。
只算吐字,时间能掐出来。一段大约 2000 token 的代码,每秒 30 个大约要 67 秒,每秒 50 个大约 40 秒。一次大约 2 万 token 的智能体输出,从大约 11 分钟缩到大约 6.7 分钟。
表外的时间它不管。编程智能体还要规划、调用工具、跑代码、检查结果。那一段不会因为字流变快就消失。一项任务从头到尾省下来的比例,会低于这张表。流式输出更快,也不证明答案更好,更不证明复杂任务更早做完。公告里没有独立测量。
OpenAI 也没有说,这次提速等于每一种普通 ChatGPT 对话里都能用上 Astra 或 Sol。公开报道把范围卡在:符合条件的订阅用户,在 OpenAI 自家产品里,或在 Sign in with ChatGPT 的合作应用里,使用这两款模型。
登录一接上,外面的工具跟着快
这次快的,不只是 ChatGPT 那个输入框。
Sign in with ChatGPT 让符合条件的人,把 ChatGPT 套餐用到参与计划的应用里。用量记在套餐上,不必另拿一把 API 密钥。人可以给单个应用设每周限额,到 ChatGPT 设置里看自己用了多少。某个应用的限额,不会另开一池额度。
所以开源编程工具 OpenCode、Pi、Amp,以及 Cognition 的 Devin,订阅一侧提速,会原样传过去。开发者可以大半天都待在外面的工具里。账号关系和用量分配,仍在 OpenAI 手里。看智能体一行行往外写的时候,快不快,就是产品本身。
按 token 付费的 API 呢?Tibo 这次没提。核对公开报道时,API 文档也还没写上这次默认速度。订阅变快,不能直接写成接口侧也变快。
分词器省了字,窗口没有被抬高
他还提到另一件事:两款模型用上了高度优化的分词器,完成同样任务需要的 token 更少。少多少,没有数字,旁边也没有基准测试。
对订阅用户,这件事可能比「看起来更快」更贴额度。Codex 和 ChatGPT Work 按 token 消耗计。同一项任务少用 token,同样的额度就能多干一点活。单纯把吐字加快,限额若不动,人只是更早撞上五小时窗口的天花板。公告没有说这些限额有没有调,模型本身有没有换,分给每次请求的算力有没有变。
GPT-6.1 Sol 是 9 月 29 日在 DevDay 上发布的。第三方测试当时发现,它完成同样任务,输出 token 要比上一代多出大约 10% 到 30%。新分词器能抵掉多少,要等独立测试重新跑。官方没有给这个数。
分工和价钱,公开材料写得很清楚。GPT-6 Astra 是旗舰,扛重推理和重编程。API 标准价是每百万输入 token 10 美元、输出 50 美元。GPT-6.1 Sol 对着编程、电脑操作和专业工作,官方说法是接近 Astra 的智能,标准 API 的输入和输出价格都是 Astra 的五分之一,也就是输入 2 美元、输出 10 美元。这次订阅侧提速,两款一起覆盖。
第一天交的是流速
日子对得上。10月4日,Tibo 给团队立了 28 天。每一天,要么交出一件对大多数 Codex 和 ChatGPT Work 用户都算明显改进的东西,要么给一次全面的用量重置。
速度刚好卡在「打开就能感到」这条线上。不挑场景。写代码、查资料、盯着智能体干活,字都来得更快。也不用人去学一个新功能。在一份每天都要交作业的约定里,这种改动最容易被认作合格。
Ethan Mollick 在 X 上说,「重置」这套做法很奇怪,只有很小一部分人看得懂。多数人希望能理性地规划用量,而不是随机拿到一批 token。提速谁都感觉得到,比重置更好懂。
所以第一天交的是流速。额度规则原文没动。字更快,不代表撞上限之前能干的活变多。分词器若真的省 token,那才碰得到额度;省多少,还是空的。
用户能核对的预期就一句:输出更快,设置不用改。端到端的编程智能体到底快了多少,取决于延迟和任务完成时间。那两项,这条帖子没有给。
哈基米云报道
做项目需要大模型,国内的、国外的这里都能接到。价格谈得下来,调用稳得住,出了问题有人跟到落地。
平顶山市哈基米与他的朋友们科技有限公司
联系电话:17629730802
公司官网:hajimi.yun