最高8倍速!价只比Astra标准档贵两成!极速档铺开了!
北京时间10月9日凌晨2点45分,OpenAI开发者社区挂出一则公告。页面时间是10月8日18:45 UTC。GPT-6.1 Sol的Ultrafast模式,当天在API、Codex和ChatGPT Work铺开。官方原话写得很满:接近Astra的智能,速度最高可达Sol标准档的8倍,好让人按想法冒出来的速度去搭东西。
这不是一款新模型。模型ID还是gpt-6.1-sol。Ultrafast是服务档。官方文档写明,要最快的响应,就在Responses API里把模型设成gpt-6.1-sol,把service_tier设成ultrafast。Ultrafast文档还写了一句范围:GPT-6 Astra和GPT-6.1 Sol已经普遍开放,GPT-5.6 Sol仍停在预览。
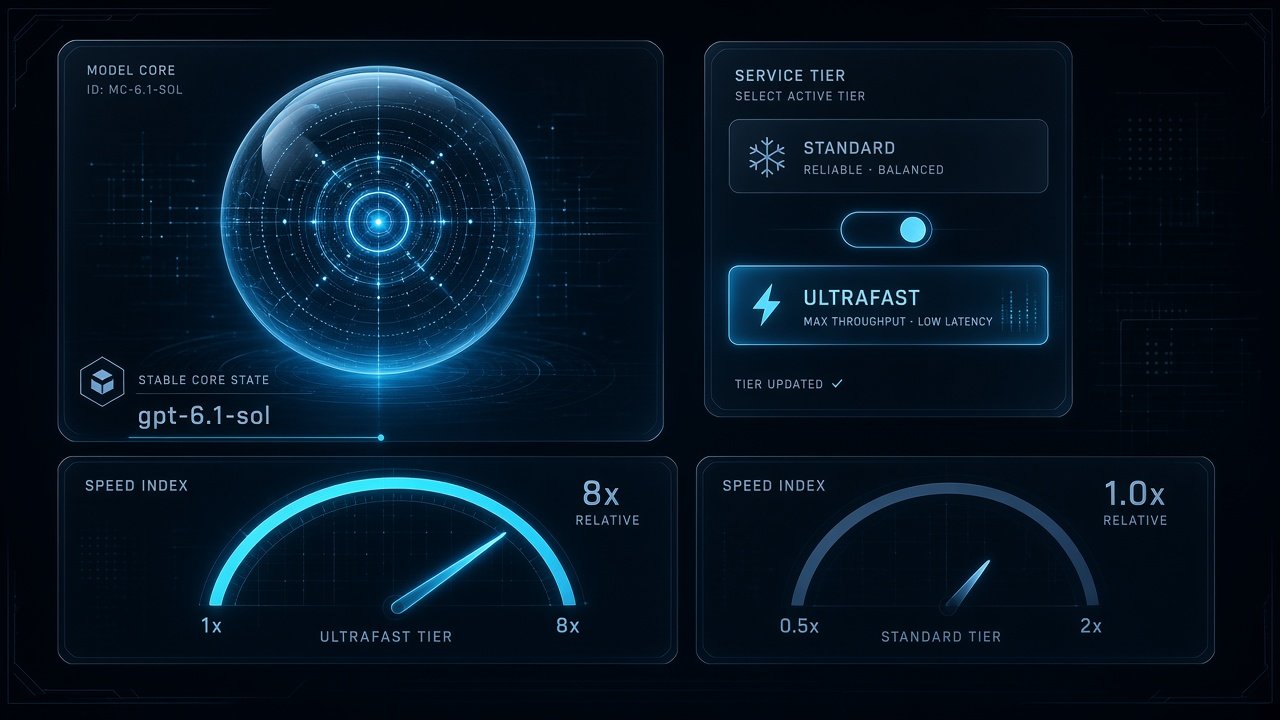
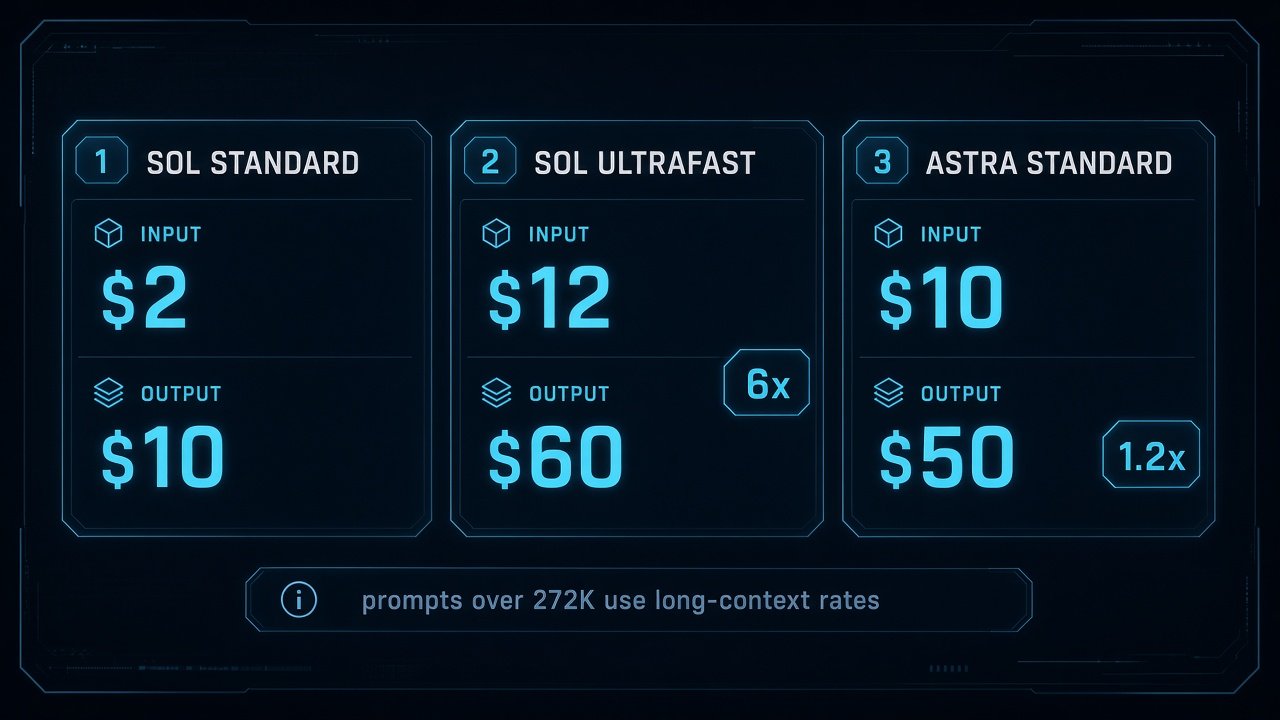
API的价,公告写死了。每百万token,输入12美元,输出60美元。下一句是:这只是Astra成本的1.2倍。Astra标准档是输入10美元、输出50美元。12除以10,60除以50,都是1.2。
相对Sol自己的标准档,则是6倍。模型页写着:Fast是标准价的2倍,Ultrafast是标准价的6倍。短上下文标准价是输入2美元、缓存读取0.10美元、缓存写入2.50美元、输出10美元。乘上6,就是定价页Ultrafast那一行:输入12美元、缓存读取0.60美元、缓存写入15美元、输出60美元。
提示一超过27.2万输入token,整次请求改按长上下文计。输入和缓存按2倍,输出按1.5倍。Ultrafast长上下文因此是输入24美元、缓存读取1.20美元、缓存写入30美元、输出90美元。数据驻留这类区域处理,定价页写的是在可用处再加10%。
同一张表上,Astra的Ultrafast短上下文是输入60美元、输出300美元。Sol这档是12和60,价目相除大约是五分之一。这是两行价目的对照。公告原文比的是Astra标准价的1.2倍,没有写成「Astra极速档的五分之一」。
谁能用,分成两摊。
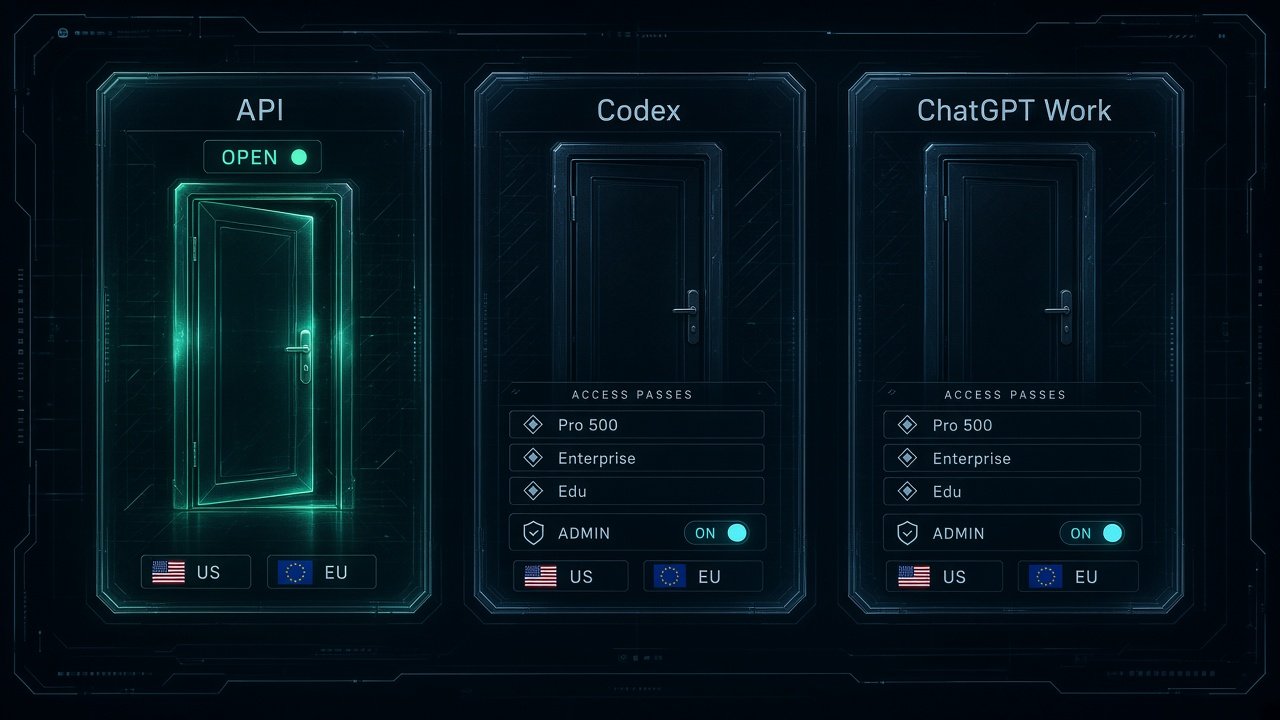
API这边,文档写:GPT-6.1 Sol的Ultrafast对全部API用户开放。限额和Standard、Fast分开。默认每分钟token上限,Build是100万,Launch是400万,Grow是4000万。同一页里,Astra的Ultrafast默认是50万、100万、500万。Sol这档的默认额度更宽。文档提醒先核对组织限额;有客户团队的,再去申请加额。
Codex和ChatGPT Work更窄。公告写:Pro 500、符合条件的按量付费企业版、按额度计费的教育版可以用。企业版要管理员打开。
区域也分开写了。GPT-6.1 Sol的Ultrafast在所有已支持区域可用,并支持美国和欧盟数据驻留,以及全球处理。同一则公告补了一笔:GPT-6.1 Sol Fast和GPT-6 Luna Fast,新加上了欧盟数据驻留。Astra的Ultrafast只支持美国数据驻留和全球处理。
速度没有毫秒表。文档把Ultrafast定义成API里最快的服务档,并强烈建议走WebSocket。理由落在智能体上:一轮接一轮调工具时,没有一条持续连接,网络开销会把延迟优势吃掉。HTTP也能打。单次一问一答,继续用HTTP就行;工具调用又密又长,才值得把连接挂住。
参数不换模型。model用gpt-6.1-sol,service_tier用ultrafast。文档示例代码里的模型名写的是gpt-6-astra,配置说明同时列出两个ID。接到Sol上,把模型名换过来。后续回合可以沿用同一条连接,带上上一轮的previous_response_id。
公告点了三类活:排查线上故障、让智能体在应用里导航、每一秒都算数的现场交互。同一时段,AWS宣布Amazon Bedrock上也提供这档。页面时间是10月8日19:41 UTC,北京时间大约凌晨3点41分。它点名的场景是实时编程助手、交互式智能体,以及要快又要质量的对客体验。
被加速的这款模型,定位写在更早的介绍页上。它是GPT-6 Sol的升级。做智能体编程、操作电脑和专业工作时接近Astra,标准输入和输出是Astra的五分之一。上下文窗口105万token,输入上限92.2万,输出上限12.8万,知识截止到2026年4月30日。推理力度有low到max,默认medium,不支持none和minimal。工具调用走Responses API。介绍页当时预告,Codex里的token生成速度最高可达标准速度的8倍。ChatGPT普通对话里,介绍页写过这款模型还没有提供。
账可以这么拆。赶时间的活,走Ultrafast:短上下文12美元进、60美元出,是Sol标准档的6倍,也是Astra标准档的1.2倍。不赶的活,标准档仍是2美元进、10美元出。企业要在Codex和ChatGPT Work里开这档,管理员得先拨开关。最高8倍是上限说法,不是每一次请求的保证。
哈基米云报道
做项目需要大模型,国内的、国外的这里都能接到。价格谈得下来,调用稳得住,出了问题有人跟到落地。
平顶山市哈基米与他的朋友们科技有限公司
联系电话:17629730802
公司官网:hajimi.yun